Decode长度预测的误差下界
LLM解码长度预测的瓶颈是“随机性天花板”
现有基准把预测器能力和任务难度混为一谈。我们把自回归解码建模为停时随机过程,证明每提示解码长度近似正态,并给出 σ=αμ+b 方差律和误差下界;多种 prefill 预测器都逼近同一边界,在我们看来,问题的系统误差压倒模型误差。
我们呼吁新的数据集包括固定模型/数据/采样参数,并同时报告相对与绝对误差。
这个工作是寒假的旧工作了,当时参加华为的难题揭榜,最终还是自己技不如人。为了防止自己完全浪费了什么,或是做了无用功,把关于这个问题的思考记录在这里。
Decode 长度预测器是推理调度系统中的一个重要的组件。现在 PD 分离架构几乎成了事实标准。试想如果能够在 prefill 结束时提前知道每个请求Decode的长度,那么在组batch的时候就可以以最优化的方式,最小化batch的切换,降低抢占、阻塞,甚至提升矩阵乘法的有效利用率。
但是我们尝试之后发现,单独预测每个请求的长度其实是非常困难的。这主要是由于Decode采样过程中的随机性导致的。考虑一个非常简单的 1-gram 语言模型,它的输出长度完全取决于它什么时候输出 EOS token,这是一个标准的几何分布模型,方差高达 \(O(1/p^2)\)
不过,我们实际实验的结果并不支持几何分布,反而是非常标准的正态分布:
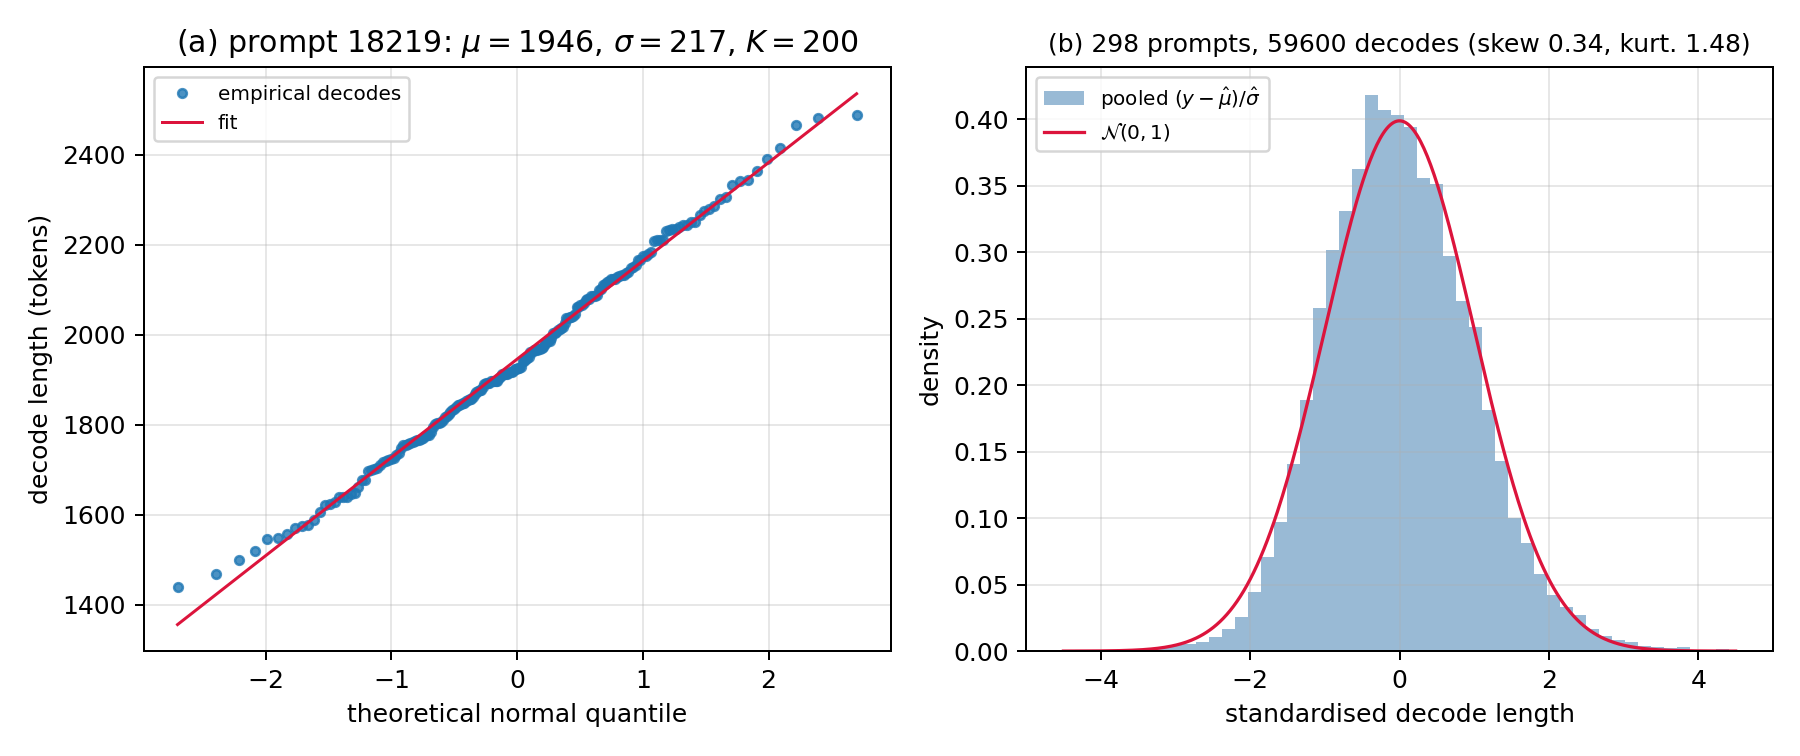
在和 deepseek 讨论之下,我们将分析长度的粒度从 token 放缩到 segment/paragraph,这种关联更弱的单位,尝试证明了,在一定假设下,最终的输出长度服从正态分布。也同时做了大量的实验来观察这一点。
这个正态分布的标准差就标记了输出长度的一个下界。即使做出最好的预测 \(y=\mu\),\(MAE\) 也有 $ 0.79 $ 的随机误差,这是正态分布自带的系统误差,和预测器的能力是没什么关系的。
可以尝试分析这个 \(\sigma\) 和什么有关。相关的变量包括模型(及其后训练变体)、提示词、采样温度等等,我们没有那么多资源对这些内容逐一控制变量。一个值得注意的观察是,样本本身输出所需 token 越多,\(\sigma\) 也就越大,整体呈现正相关的趋势(这很符合直觉),但是 R^2 并不好看。我们尝试测量了 \(\mu-\sigma\) 之间的仿射关系,也不能称得上很好。
在我看来,指望P阶段结束时一次性完成预判是较为困难的。应该考虑一些曲线救国的方案,例如 ELIS 就是一个迭代的预测系统,在decode一定步数之后对于输出长度进行纠正,动态调度请求;Mooncake 这种生产级别的系统,则放弃了对每个请求的独立预测,而是预测接下来的一段时间内,某台机器/某个计算阶段的整体负载,让大量样本的叠加冲淡单样本的随机性,是更为务实的选择。